


循环 sleep
这种方式最简单,只要在循环里加入需要执行的代码,然后sleep后在执行。
import time
# 每n秒执行一次def timer(n): while True: function(*args,**kargs) time.sleep(n)# 5stimer(5)这个方法的缺点:只能执行固定间隔时间的任务,如果有定时任务就无法完成。并且sleep是一个阻塞函数,也就是说sleep这一段时间,啥都不能做。
threading模块中的Timer
threading模块中的Timer是一个非阻塞函数,比sleep稍好一点。
from threading import Timer
def Timertion(second): function(*args, **kargs) t = Timer(second, printTime, (*args, **kargs)) t.start()# 5sTimertion(5)Timer 函数第一个参数是时间间隔(单位是秒),第二个参数是要调用的函数名,第三个参数是调用函数的参数(tuple)
sched模块
sched 模块是 Python 内置的模块,它是一个调度(延时处理机制),每次想要定时执行某任务都必须写入一个调度。
import schedimport time
# 初始化sched模块的 scheduler 类# 第一个参数是一个可以返回时间戳的函数,第二个参数可以在定时未到达之前阻塞。schedule = sched.scheduler(time.time, time.sleep)# 被周期性调度触发的函数def Timertion(second): function(*args, **kargs) schedule.enter(second, 0, function, (*args, **kargs))# 默认参数60sdef main(second=60): # enter四个参数分别为:间隔时间、优先级(用于同时间到达的两个事件同时执行时定序)、被调用触发的函数, # 第四个:给该触发函数的参数(tuple形式) schedule.enter(0, 0, function, (*args, **kargs)) schedule.run()
# 10s 输出一次main(10)使用注意:
(1)传调用函数的参数时,一定要以 tuple 给,如果只有一个参数就(xx,)
(2)sched 模块不是循环的,一次调度被执行后就 Over 了,如果想再执行,请再次 enter
APScheduler定时框架
终于找到了可以每天定时运行指定代码的方式了
APScheduler是一个 Python 定时任务框架,使用起来十分方便。提供了基于日期、固定时间间隔以及 crontab 类型的任务,并且可以持久化任务、并以 daemon 方式运行应用。
from apscheduler.schedulers.blocking import BlockingScheduler
def every_job(): function(*args, **kargs)
# BlockingSchedulerscheduler = BlockingScheduler()scheduler.add_job(every_job, 'cron', day_of_week='1-6', hour=16, minute=40)scheduler.start()代码中的 BlockingScheduler 是什么呢?
BlockingScheduler 是 APScheduler 中的调度器,APScheduler 中有两种常用的调度器,BlockingScheduler 和 BackgroundScheduler,当调度器是应用中唯一要运行的任务时,使用 BlockingSchedule,如果希望调度器在后台执行,使用 BackgroundScheduler。
1. BlockingScheduler: use when the scheduler is the only thing running in your process2. BackgroundScheduler: use when you’re not using any of the frameworks below, and want the scheduler to run in the background inside your application3. AsyncIOScheduler: use if your application uses the asyncio module4. GeventScheduler: use if your application uses gevent5. TornadoScheduler: use if you’re building a Tornado application6. TwistedScheduler: use if you’re building a Twisted application7. QtScheduler: use if you’re building a Qt applicationAPScheduler四个组件
APScheduler 四个组件分别为:触发器(trigger),作业存储(job store),执行器(executor),调度器(scheduler)。
触发器(trigger)
包含调度逻辑,每一个作业有它自己的触发器,用于决定接下来哪一个作业会运行。除了他们自己初始配置意外,触发器完全是无状态的。
APScheduler 有三种内建的 trigger:
- date: 特定的时间点触发
- interval: 固定时间间隔触发
- cron: 在特定时间周期性地触发
作业存储(job store)
存储被调度的作业,默认的作业存储是简单地把作业保存在内存中,其他的作业存储是将作业保存在数据库中。一个作业的数据讲在保存在持久化作业存储时被序列化,并在加载时被反序列化。调度器不能分享同一个作业存储。
APScheduler 默认使用 MemoryJobStore,可以修改使用 DB 存储方案
执行器(executor)
处理作业的运行,他们通常通过在作业中提交制定的可调用对象到一个线程或者进城池来进行。当作业完成时,执行器将会通知调度器。
最常用的 executor 有两种:
- ProcessPoolExecutor
- ThreadPoolExecutor
调度器(scheduler)
通常在应用中只有一个调度器,应用的开发者通常不会直接处理作业存储、调度器和触发器,相反,调度器提供了处理这些的合适的接口。配置作业存储和执行器可以在调度器中完成,例如添加、修改和移除作业。
配置调度器
APScheduler提供了许多不同的方式来配置调度器,灵活性强
from apscheduler.schedulers.blocking import BlockingScheduler
def job(): function(*args, **kargs)
# 定义BlockingSchedulersched = BlockingScheduler()sched.add_job(job, 'interval', seconds=5)sched.start()上述代码创建了一个 BlockingScheduler,并使用默认内存存储和默认执行器。(默认选项分别是 MemoryJobStore 和 ThreadPoolExecutor,其中线程池的最大线程数为10)。配置完成后使用 start() 方法来启动。
如果想要显式设置 job store(使用mongo存储)和 executor 可以这样写:
from pymongo import MongoClientfrom apscheduler.schedulers.blocking import BlockingSchedulerfrom apscheduler.jobstores.memory import MemoryJobStorefrom apscheduler.jobstores.mongodb import MongoDBJobStorefrom apscheduler.executors.pool import ThreadPoolExecutor, ProcessPoolExecutor# MongoDB 参数host = '127.0.0.1'port = 27017client = MongoClient(host, port)# 输出时间def job(): function(*args, **kargs)# 存储方式jobstores = { 'mongo': MongoDBJobStore(collection='job', database='test', client=client), 'default': MemoryJobStore()}executors = { 'default': ThreadPoolExecutor(10), 'processpool': ProcessPoolExecutor(3)}job_defaults = { 'coalesce': False, 'max_instances': 3}scheduler = BlockingScheduler(jobstores=jobstores, executors=executors, job_defaults=job_defaults)scheduler.add_job(job, 'interval', seconds=5, jobstore='mongo')scheduler.start()在 MongoDB 中可以看到 job 的状态
对 job 的操作
添加 job
-
add_job()
-
scheduled_job()
第二种方法只适用于应用运行期间不会改变的 job,而第一种方法返回一个apscheduler.job.Job 的实例,可以用来改变或者移除 job。from apscheduler.schedulers.blocking import BlockingSchedulersched = BlockingScheduler()# 装饰器@sched.scheduled_job('interval', id='my_job_id', seconds=5)def job_function():print("Hello World")# 开始sched.start()
删除 job
-
remove_job()
-
job.remove()
remove_job 使用 jobID 移除
job.remove() 使用 add_job() 返回的实例job = scheduler.add_job(myfunc, 'interval', minutes=2)job.remove()# idscheduler.add_job(myfunc, 'interval', minutes=2, id='my_job_id')scheduler.remove_job('my_job_id')
暂停和恢复 job
暂停:
apscheduler.job.Job.pause()apscheduler.schedulers.base.BaseScheduler.pause_job()恢复:
apscheduler.job.Job.resume()apscheduler.schedulers.base.BaseScheduler.resume_job()希望你还记得 apscheduler.job.Job 是 add_job() 返回的实例
获取 job 列表
获得可调度 job 列表,可以使用get_jobs() 来完成,它会返回所有的 job 实例.也可以使用print_jobs() 来输出所有格式化的 job 列表。
修改 job
除了 jobID 之外 job 的所有属性都可以修改,使用 apscheduler.job.Job.modify() 或者 modify_job() 修改一个 job 的属性
job.modify(max_instances=6, name='Alternate name')modify_job('my_job_id', trigger='cron', minute='*/5')关闭 job
默认情况下调度器会等待所有的 job 完成后,关闭所有的调度器和作业存储。将 wait 选项设置为 False 可以立即关闭。
scheduler.shutdown()scheduler.shutdown(wait=False)scheduler 事件
scheduler 可以添加事件监听器,并在特殊的时间触发。
def my_listener(event): if event.exception: print('The job crashed :(') else: print('The job worked :)')# 添加监听器scheduler.add_listener(my_listener, EVENT_JOB_EXECUTED | EVENT_JOB_ERROR)trigger 规则
date
最基本的一种调度,作业只会执行一次。它的参数如下:
-
run_date (datetime|str) – the date/time to run the job at
-
timezone (datetime.tzinfo|str) – time zone for run_date if it doesn’t have one already
from datetime import datefrom apscheduler.schedulers.blocking import BlockingSchedulersched = BlockingScheduler()def my_job(text):print(text)# The job will be executed on November 6th, 2009sched.add_job(my_job, 'date', run_date=date(2009, 11, 6), args=['text'])sched.add_job(my_job, 'date', run_date=datetime(2009, 11, 6, 16, 30, 5), args=['text'])sched.add_job(my_job, 'date', run_date='2009-11-06 16:30:05', args=['text'])# The 'date' trigger and datetime.now() as run_date are implicitsched.add_job(my_job, args=['text'])sched.start()
- year (int|str) – 4-digit year
- month (int|str) – month (1-12)
- day (int|str) – day of the (1-31)
- week (int|str) – ISO week (1-53)
- day_of_week (int|str) – number or name of weekday (0-6 or mon,tue,wed,thu,fri,sat,sun)
- hour (int|str) – hour (0-23)
- minute (int|str) – minute (0-59)
- second (int|str) – second (0-59)
- start_date (datetime|str) – earliest possible date/time to trigger on (inclusive)
- end_date (datetime|str) – latest possible date/time to trigger on (inclusive)
- timezone (datetime.tzinfo|str) – time zone to use for the date/time calculations (defaults to scheduler timezone)
表达式:
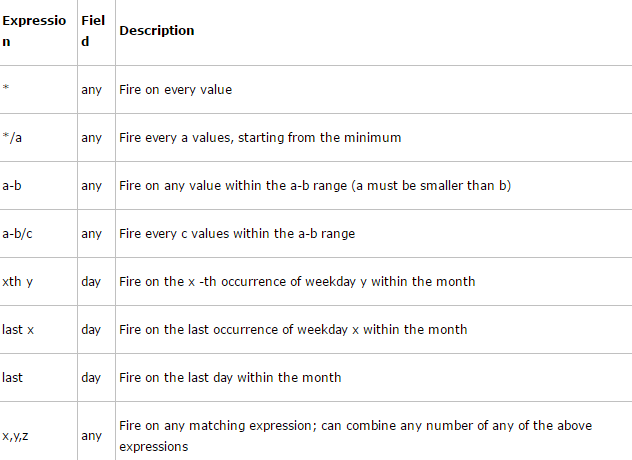
from apscheduler.schedulers.blocking import BlockingScheduler
def job_function(): print("Hello World")# BlockingSchedulersched = BlockingScheduler()# Schedules job_function to be run on the third Friday# of June, July, August, November and December at 00:00, 01:00, 02:00 and 03:00sched.add_job(job_function, 'cron', month='6-8,11-12', day='3rd fri', hour='0-3')# Runs from Monday to Friday at 5:30 (am) until 2014-05-30 00:00:00sched.add_job(job_function, 'cron', day_of_week='mon-fri', hour=5, minute=30, end_date='2014-05-30')sched.start()interval
参数:
- weeks (int) – number of weeks to wait
- days (int) – number of days to wait
- hours (int) – number of hours to wait
- minutes (int) – number of minutes to wait
- seconds (int) – number of seconds to wait
- start_date (datetime|str) – starting point for the interval calculation
- end_date (datetime|str) – latest possible date/time to trigger on
- timezone (datetime.tzinfo|str) – time zone to use for the date/time calculations
from datetime import datetimefrom apscheduler.schedulers.blocking import BlockingScheduler
def job_function(): print("Hello World")# BlockingSchedulersched = BlockingScheduler()# Schedule job_function to be called every two hourssched.add_job(job_function, 'interval', hours=2)# The same as before, but starts on 2010-10-10 at 9:30 and stops on 2014-06-15 at 11:00sched.add_job(job_function, 'interval', hours=2, start_date='2010-10-10 09:30:00', end_date='2014-06-15 11:00:00')sched.start()