


987 字
5 分钟
计算机缓存的替换策略(算法)
目前常见的替换策略有随机、FIFO、LFU、LRU 四种。下面三种(FIFO / LFU / LRU)都依赖双向链表做 O(1) 的节点移动,所以先把它实现出来。
随机算法(Random)本身没什么可实现的——命中淘汰时从缓存里随便挑一个踢掉即可,不需要维护任何顺序结构,实现最简单但命中率也最差,这里不单独展开。
基础:双向链表 python 实现
class Node: def __init__(self, key, value): self.key = key self.value = value self.prev = None self.next = None
def __str__(self): val = f'{{{self.key} : {self.value}}}' return val
def __repr__(self): val = f'{{{self.key} : {self.value}}}' return val
class DoubleLinkedList: def __init__(self, capacity=0xffff): self.capacity = capacity self.head = None self.tail = None self.size = 0
# 从头部添加 def add_head(self, node: Node): if not self.head: self.head = node self.tail = node self.head.next = None self.head.prev = None else: node.next = self.head self.head.prev = node self.head = node self.head.prev = None self.size += 1 return node
# 从尾部添加 def add_tail(self, node: Node): if not self.tail: self.tail = node self.head = node self.tail.next = None self.tail.prev = None else: self.tail.next = node node.prev = self.tail self.tail = node self.tail.next = None self.size += 1 return node
# 从尾部删除 def del_tail(self): if not self.tail: return node = self.tail if node.prev: self.tail = node.prev self.tail.next = None else: self.tail = self.head = None self.size -= 1 return node
# 从头部删除 def del_head(self): if not self.head: return node = self.head if node.next: self.head = node.next self.head.prev = None else: self.tail = self.head = None self.size -= 1 return node
# 从任意节点删除 def remove(self, node: Node): # 如果node= None ,默认删除尾部节点 if not node: node = self.tail if node == self.tail: self.del_tail() elif node == self.head: self.del_head() else: node.prev.next = node.next node.next.prev = node.prev self.size -= 1 return node
def print(self): p = self.head line = "" while p: line += "%s" % p p = p.next if p: line += "=>" print(line)先进先出算法(FIFO)
✦把缓存看作是一个先进先出的队列
✦优先替换最先进入队列的字块
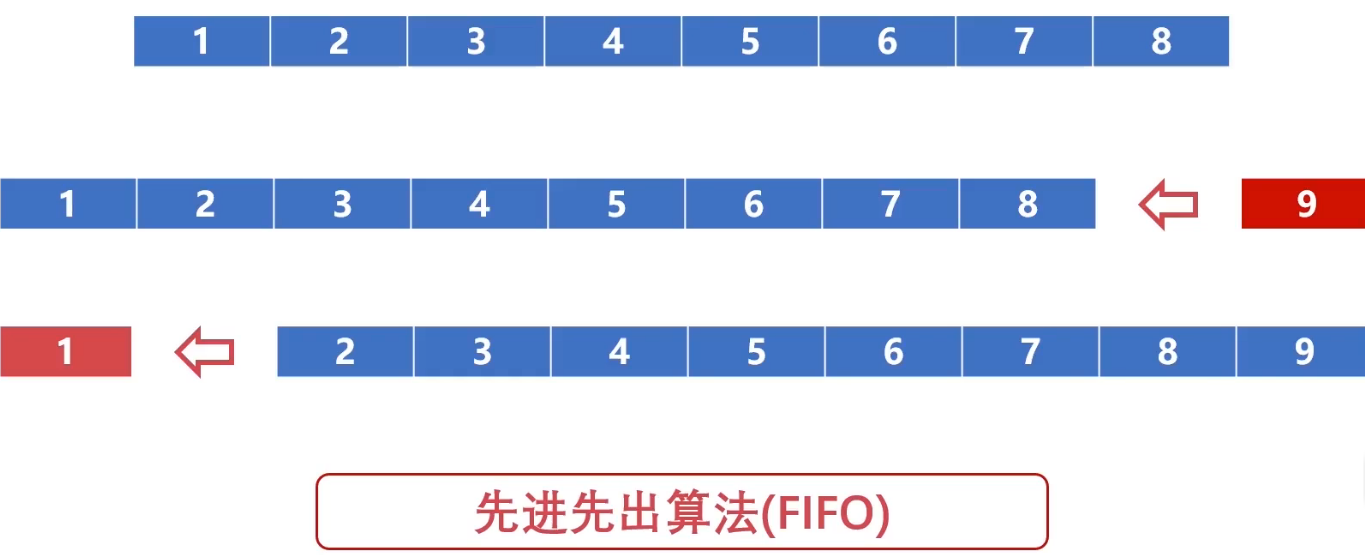
python 实现代码
from DoubleLinkedList import DoubleLinkedList, Node
class FIFOCache(): def __init__(self, capacity): self.capacity = capacity self.size = 0 self.map = {} self.list = DoubleLinkedList(self.capacity)
def get(self, key): if key not in self.map: return -1 else: node: Node = self.map.get(key) return node.value
def put(self, key, value): if self.capacity == 0: return "容量为0" if key in self.map: node: Node = self.map.get(key) self.list.remove(node) node.value = value self.list.add_tail(node) else: if self.size == self.capacity: node = self.list.del_tail() del self.map[node.key] self.size -= 1 node = Node(key, value) self.list.add_tail(node) self.map[key] = node self.size += 1
def print(self): return self.list.print()最不经常使用算法(LFU)
✦优先淘汰最不经常使用的字块
✦需要额外的空间记录字块的使用频率
✦ 同频率节点按FIFO算法淘汰
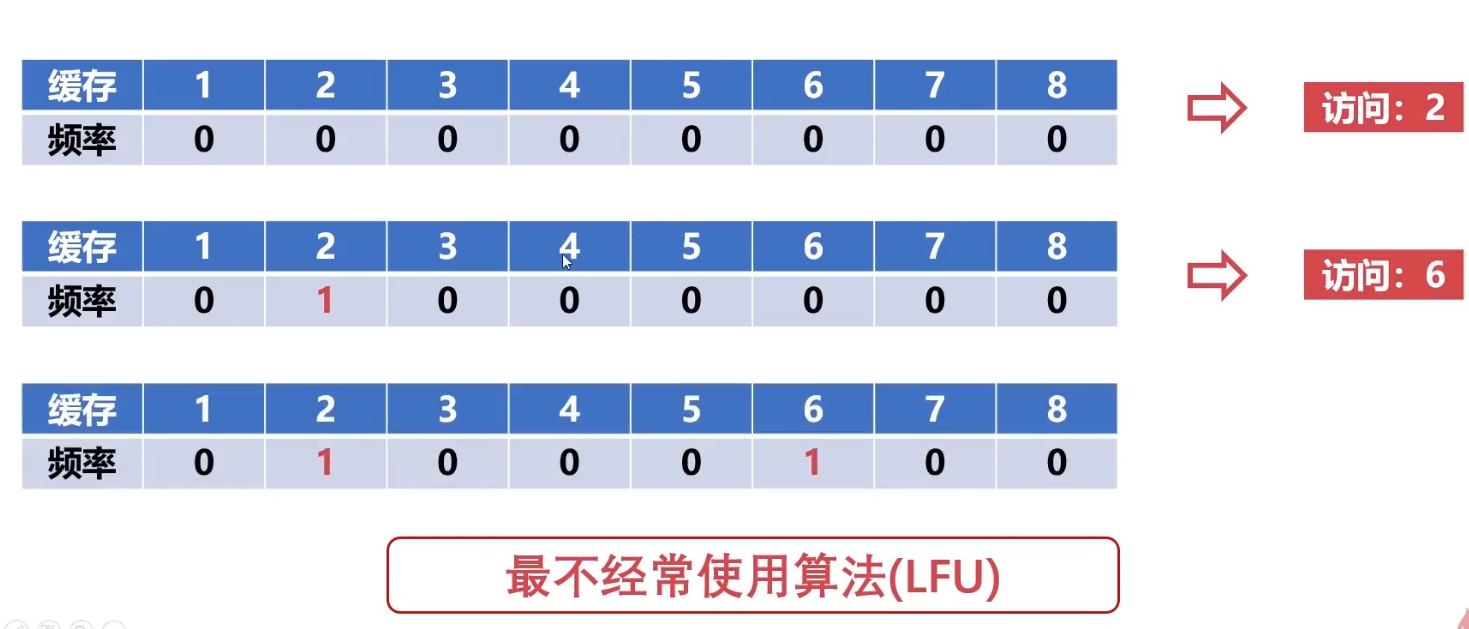
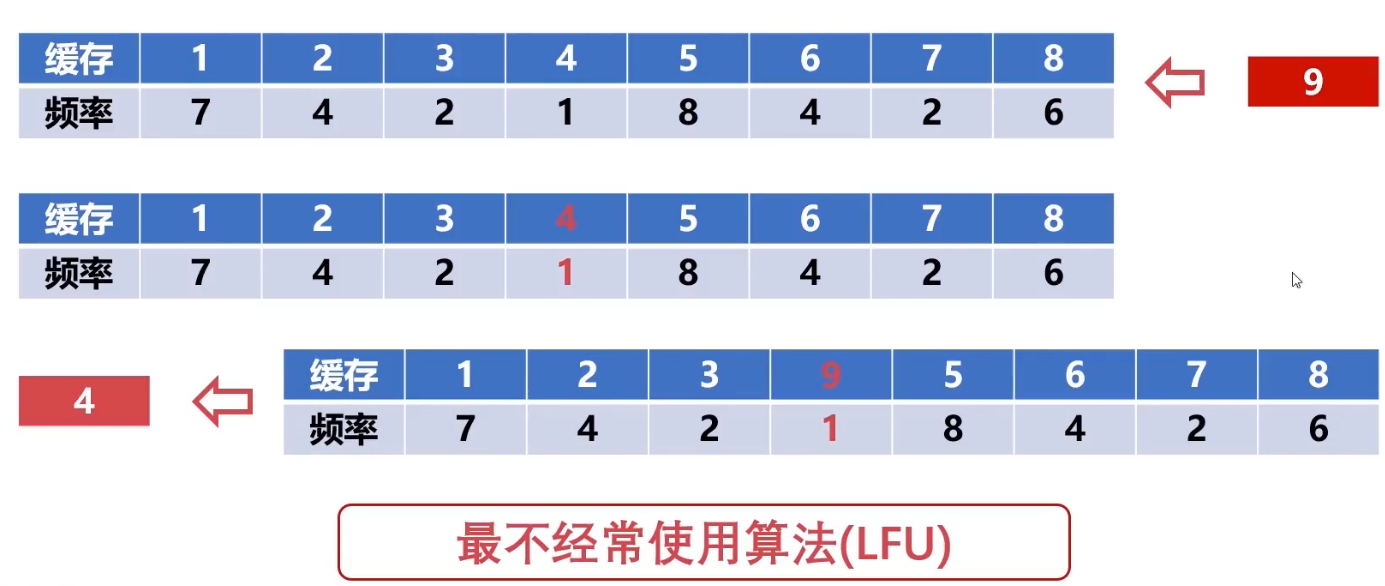
from DoubleLinkedList import DoubleLinkedList, Node
class LFUNode(Node): def __init__(self, key, value): self.freq = 0 # 频率 super(LFUNode, self).__init__(key, value)
class LFUCache(): def __init__(self, capacity): self.capacity = capacity self.map = {} # key :频率 value: 频率对应的双向链表 self.freq_map = dict() self.size = 0
# 更新节点频率的操作 def update_freq(self, node: LFUNode): freq = node.freq # 删除 node = self.freq_map[freq].remove(node) if self.freq_map[freq].size == 0: del self.freq_map[freq] # 更新 freq += 1 node.freq = freq if freq not in self.freq_map: self.freq_map[freq] = DoubleLinkedList() self.freq_map[freq].add_tail(node)
def get(self, key): if key not in self.map: return -1 node = self.map.get(key) self.update_freq(node) return node.value
def put(self, key, value): if self.capacity == 0: return "容量为0" # 缓存命中 if key in self.map: node = self.map.get(key) node.value = value self.update_freq(node) # 缓存没命中 else: if self.capacity == self.size: min_freq = min(self.freq_map) node = self.freq_map[min_freq].del_tail() del self.map[node.key] self.size -= 1
node = LFUNode(key, value) node.freq = 1 self.map[key] = node if node.freq not in self.freq_map: self.freq_map[node.freq] = DoubleLinkedList() node = self.freq_map[node.freq].add_tail(node) self.size += 1
def print(self): print("***************") for k, v in self.freq_map.items(): print(f"频率= {k}") self.freq_map[k].print()最近最少使用算法(LRU)
✦优先淘汰一段时间内没有使用的字块
✦有多种实现方法,一般使用双向链表
✦把当前访问节点置于链表前面(保证链表头部节点是最近使用的)
✦缓存淘汰时,把链表尾部的节点淘汰即可
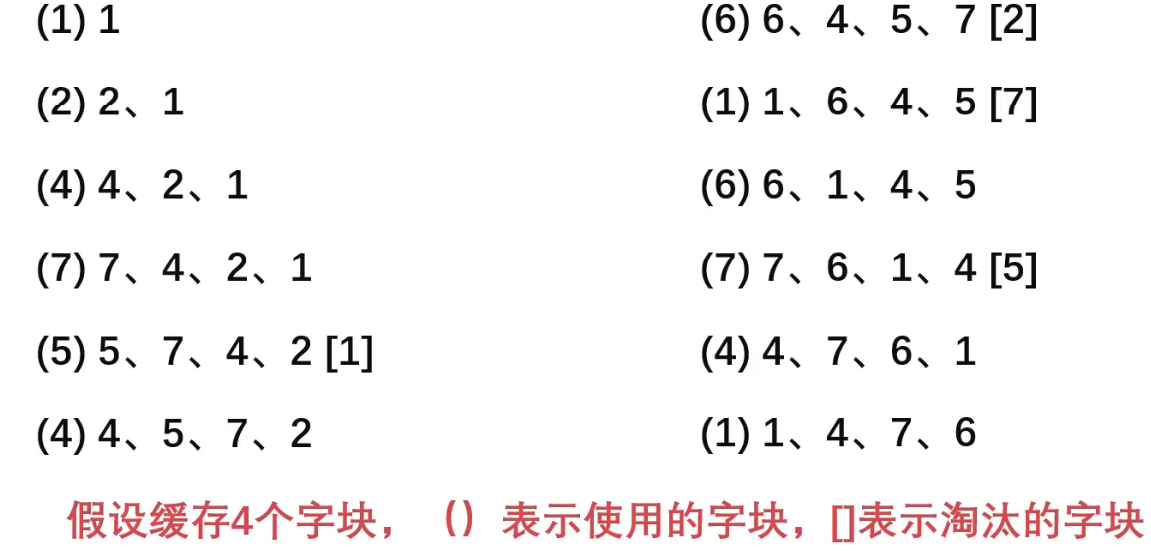
python 代码实现
from DoubleLinkedList import DoubleLinkedList, Node
class LRUCache(): def __init__(self, capacity): self.capacity = capacity self.map = {} self.list = DoubleLinkedList(self.capacity)
def get(self, key): if key in self.map: node: Node = self.map[key] self.list.remove(node) self.list.add_head(node) return node.value else: return -1
def put(self, key, value): if key in self.map: node: Node = self.map.get(key) self.list.remove(node) node.value = value self.list.add_head(node) else: node = Node(key, value) # 缓存已经满了 if self.list.capacity <= self.list.size: old_node = self.list.del_tail() self.map.pop(old_node.key)
# 缓存没满 self.list.add_head(node) self.map[key] = node
def print(self): self.list.print()LRU 问题:时间复杂度? 多线程下怎么优化?
计算机缓存的替换策略(算法)
https://gilgameshzzz.github.io/posts/缓存替换策略/